 poxiaoxi博客
如果每天都需要跟踪几十个行业网站、公众号、社交账号和产品更新,一个很现实的问题是:真正重要的信息只占其中一小部分,但人工筛选、整理和写日报却会消耗大量时间。
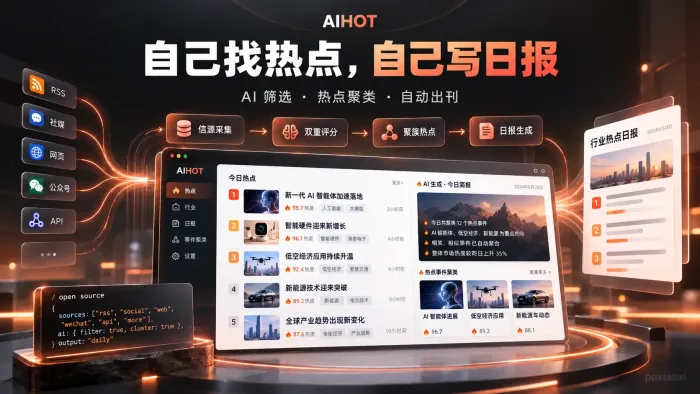
GitHub上的AIHOT项目解决的正是这类需求。它不是单纯的RSS阅读器,也不是把抓到的文章全部交给AI总结,而是一套从信源采集、预筛、两次评分、内容写作、事件聚簇、热度计算一直到日报发布的完整行业热点网站框架。
项目作者本身运营了一个AI热点网站,开源仓库则提供了其中的完整框架。使用者可以把AI行业的示范配置换成法律、人力资源、金融、贵金属、开发者工具等其他垂直领域,建立自己的行业资讯站。
AIHOT到底是什么项目
按照项目官方说明,AIHOT会每天从设定好的信源中采集资料,先进行去重和预筛,再让大模型按照同一套标准独立评分两次。达到门槛的内容才进入精选流程,并生成中文标题、摘要、推荐理由和标签。
如果多个来源报道的是同一件事情,系统还会继续把它们聚合成一个事件,而不是在首页重复展示十几篇相似新闻。
事件最终可以根据独立来源数量和时间衰减计算热度,再形成当前热点、日报、周报和月报。
所以它更接近一套“自动化行业编辑部”,而不是简单的新闻采集程序。
它不是普通的AI新闻模板
AIHOT仓库默认附带的是AI行业示范配置,但项目本身并没有限定只能用于AI资讯。
真正决定网站最终内容质量的主要有三部分:
选择哪些信源。
什么内容算重要。
什么内容应该被过滤。
这些行业相关配置主要集中在项目的industry/目录中。站名、分类、主题、初始信源、提示词、评分标准和入选门槛都可以调整,而不需要把整个系统重新开发一遍。
例如改成法律行业后,可以把“模型发布、AI融资、技术论文”换成“新法规、重大判决、监管处罚”等重要事件,同时把律所营销软文、课程广告等内容列入需要压低评分的噪声。
这也是这个项目比较值得注意的地方:它把行业经验放进了可配置的筛选规则,而不是试图用一套固定提示词处理所有行业。
目前可以接入哪些信源
AIHOT当前提供六类信源读取方式。
| 信源类型 | 适合内容 | 额外条件 |
|---|---|---|
| RSS / Atom | 博客、媒体、Substack等 | 通常不需要额外服务 |
| 网页列表 | 新闻列表、博客列表、更新日志 | 需要配置页面选择器 |
| JSON接口 | GitHub Releases等API数据 | 需要配置字段路径 |
| X账号 | X平台公开内容 | 需要SocialData服务 |
| 微信公众号 | 公众号内容 | 需要第三方公众号数据服务 |
| 外部推送 | 自己的采集脚本或数据源 | 通过Token推送 |
对于大多数行业站,可以优先从RSS、官方网站列表和公开JSON接口开始,这些数据源相对简单,也更容易长期维护。
X和微信公众号接入依赖第三方付费服务,并不是安装AIHOT以后就能免费抓取所有平台内容。
筛选过程不只是一次提问
很多AI资讯工具的处理方式,是把文章直接交给模型,然后让它判断“值不值得看”。AIHOT的流程要更细一些。
资料进入系统后会先进行预筛,把明显无关内容过滤掉。可能有价值的内容随后按照同一份评分标准独立打两次分,两个结果达到对应信源等级的门槛后,才会进入精选。
不同信源还可以划分等级。例如官方一手来源、准官方账号、媒体和个人来源可以设置不同入选要求。
项目还提供了校准流程。使用者可以自己挑选约100到200条行业资料,人工标记“应该选”还是“不应该选”,然后通过脚本查看不同评分门槛下的准确率、查准率和查全率。
从实际使用角度看,这一步可能比修改网站界面更加重要。一个热点站真正有价值的地方并不是每天采集了多少文章,而是最终留下来的内容是否符合目标读者的判断标准。
同一事件会自动归到一起
行业新闻站很容易出现一种问题:某家公司发布一项产品,官网写一篇、媒体转载十篇、社交平台继续讨论,结果首页被同一事件连续占满。
AIHOT设计了事件聚簇流程来处理这种重复。
系统会先利用标题和摘要的向量,从近期内容中寻找可能属于同一事件的候选,再让模型判断两篇报道到底是同一件事情、后续进展,还是两个不同事件。
如果模型无法确定,还可以再通过另一家模型确认。
人工修改过的事件归属不会被自动流程覆盖,这为日常运营保留了人工编辑空间。
热点不是按照文章数量计算
AIHOT的热点排序同样不是简单统计抓到了多少篇文章。
项目按照事件计算热度,在一定时间窗口内,每个独立来源只计算一次,同一家媒体重复发布多篇内容不会无限增加事件热度。
这样可以减少转载站和重复抓取对热点排名造成的干扰。
对于需要做行业情报的网站,这种思路比单纯统计文章数量更合理,因为用户真正关心的是“有多少独立来源正在讨论这件事情”,而不是数据库中存在多少个URL。
日报周报可以自动生成
完成筛选和事件整理以后,AIHOT还会继续生成日报、周报和月报。
默认设计中,每天早上生成日报,每周和每月也可以按照分类整理阶段性内容。
除了网页展示,系统还提供多种对外读取方式,包括:
精选、全部内容和日报RSS。
公开API。
MCP接口。
llms.txt。站点地图。
面向搜索引擎的robots.txt。
这意味着同一份内容不仅可以给普通网站访客阅读,也能提供给其他程序、Agent或者内部工具继续使用。
对于计划搭建行业知识监控、企业内部情报系统或者AI Agent数据源的用户,这部分能力可能比前台新闻页面本身更有价值。
部署AIHOT需要什么环境
官方推荐使用Docker Compose部署。
根据当前部署文档,服务器建议至少准备2核CPU和4GB内存,主要是构建镜像时需要一定资源。运行时还需要一个OpenAI兼容的模型API Key。
项目README明确提到DeepSeek、千问和智谱等提供OpenAI兼容接口的模型服务可以使用。
最基础的安装流程是:
git clone https://github.com/KKKKhazix/AIHOT.git myhot
cd myhot
node scripts/init-env.ts --llm-key <模型API Key>
docker compose up -d --build
启动后默认网站运行在3000端口,后台位于/admin。
Docker环境会运行PostgreSQL数据库、API服务、后台Worker和Web服务等组件。生产环境还可以通过Caddy自动配置HTTPS,或者接入已有的Nginx反向代理。
如果不用Docker,当前官方文档要求Node.js 24.11以上,并自行准备PostgreSQL 16或17以及进程守护环境。
内容版权需要自己判断
自动采集行业资讯时,另一个不能忽略的问题是原始内容的使用权限。
AIHOT在信源配置中专门提供了site_fulltext设置,并且默认关闭。也就是说,通常只在站内展示标题、摘要以及原文链接。
只有明确获得来源许可时,才建议开启站内全文展示。
这项设计很重要。开源采集框架解决的是技术上的信息获取和整理问题,并不意味着第三方文章、新闻、图片和社交内容自动获得了转载授权。
准备正式运营网站时,仍然需要根据具体信源确认版权、转载规则和平台服务条款。
精彩评论