 poxiaoxi博客
在开发网站、电商系统或者物流管理平台时,经常需要准备一些测试地址。例如,注册表单需要验证不同国家的地址格式,电商结账页面需要测试城市、邮编和街道字段,物流系统则需要模拟不同地区的收货地址。
最简单的办法是随机拼接一些城市名称、街道名称和邮政编码,但这种方式存在一个明显问题:生成的地址看起来可能比较完整,实际上却未必真实存在。地址字段之间也可能互相矛盾,例如城市与邮编不匹配,或者街道根本不属于所选择的行政区域。
GitHub上的Address项目就是针对这类问题设计的工具。它是一款支持自托管部署的真实地址生成器,数据主要来自官方地址登记资料、开放地图数据以及经过验证的地理编码结果。与完全随机拼接地址的工具不同,Address会保留数据来源、地址精度和地理坐标等信息,缺失的字段不会随意编造。
该项目目前覆盖27个国家和地区,支持多语言地址展示、指定区域筛选、单条和批量生成,并提供Web界面及JSON API。除了地址本身,还能生成与地址无关的合成测试资料,适合需要准备多地区测试数据的开发者和测试团队。
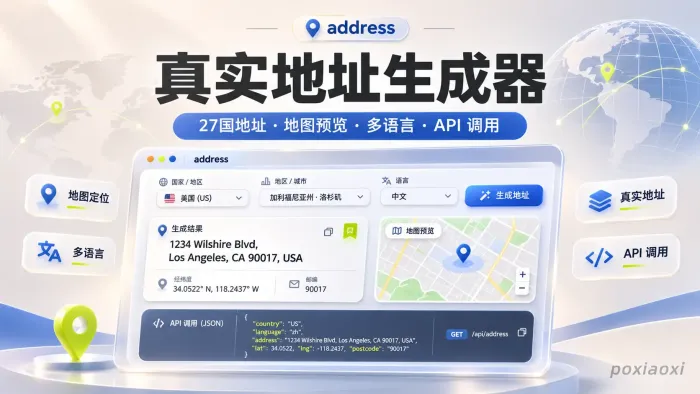
27个国家和地区覆盖范围
对于地址生成工具来说,支持多少个国家只是一个基础指标,更重要的是能否按照各个国家真实的行政区划和地址结构进行筛选。
Address目前覆盖27个国家和地区,分布在北美、欧洲、亚洲、大洋洲、中东、南美洲和非洲等区域。
| 地区 | 支持的国家和地区 |
|---|---|
| 北美洲 | 美国、加拿大、墨西哥 |
| 欧洲 | 英国、德国、法国、意大利、西班牙、荷兰、俄罗斯 |
| 东亚 | 中国、中国香港、中国台湾、日本、韩国 |
| 东南亚 | 新加坡、马来西亚、泰国、菲律宾、越南 |
| 南亚 | 印度 |
| 大洋洲 | 澳大利亚 |
| 中东 | 土耳其、沙特阿拉伯 |
| 南美洲 | 巴西 |
| 非洲 | 尼日利亚、南非 |
从覆盖范围来看,它不仅包含美国、英国、日本等常见开发测试目标,也涉及新加坡、马来西亚、泰国、越南等东南亚国家。
对于开发国际化网站的团队来说,这种覆盖方式比较实用。例如,一个跨境电商系统可能需要分别测试美国、德国、日本和新加坡的地址格式,如果每个国家都单独寻找数据源,会增加不少准备工作。
不过,覆盖27个国家和地区并不意味着每个国家的所有城市、街道和门牌都已经完整收录。具体数据数量和行政区域覆盖情况,可以通过工具提供的覆盖率页面及API进行检查。
真实地址数据来自哪里
Address与普通随机地址生成器最大的区别,在于它对数据来源和地址真实性有明确要求。
根据项目的数据来源文档,不同国家会采用不同的数据策略,并不是使用同一套地址数据覆盖全球所有地区。
主要数据来源包括:
官方地址登记资料:使用各国政府或相关机构公开的地址及建筑登记数据。
开放地图数据:通过OpenStreetMap、Overture等开放地理数据获取道路、建筑和地址信息。
官方行政区划资料:用于验证地址所属的国家、地区、城市和区县。
地理编码服务:在符合项目验证规则的情况下,使用相关服务补充地址和坐标信息。
例如,美国的数据来源包括Overture和Geofabrik等;日本使用数字厅相关地址数据及Geolonia等来源;新加坡则结合HDB物业信息、OneMap和开放地图数据。
中国大陆地区采用了不同的处理策略,主要围绕住宅小区数据进行整理,并通过行政区划、住宅分类和门牌信息等条件进行筛选。
这种按国家分别制定数据策略的方式比较重要,因为不同国家的地址管理体系并不相同。有些国家拥有比较完整的官方门牌数据库,有些地区则主要依赖道路、建筑和开放地图数据。
Address会根据实际来源保留对应的地址信息,而不是为了让每条记录看起来完整,就随意补充不存在的门牌、楼栋或邮政编码。
地址精度和住宅属性如何区分
使用地址生成工具时,有一个容易忽略的问题:街道地址、具体门牌地址和住宅地址并不是同一个概念。
例如,一条街道名称可以真实存在,但它并不一定对应某个具体住宅。即使某个地址具有经纬度,也不能仅凭坐标就判断该地点一定是住宅建筑。
Address通过地址精度和住宅属性两个字段进行区分。
| 字段 | 含义 |
|---|---|
| street | 街道级地址,能够确认道路信息,但不一定具有具体门牌。 |
| premise | 建筑或具体门牌级地址。 |
| subpremise | 更细粒度的地址,例如建筑内部的单元或具体房间。 |
| residential | 存在独立住宅用途证据的地址。 |
| unknown | 无法确认住宅属性,不应将其当作已验证的住宅地址。 |
这种区分能够避免将一条真实街道错误地标记为真实住宅。
例如,某个国家的数据源只能确认街道名称和坐标,那么该记录可以作为街道级地址使用,但不会因为附近存在住宅建筑,就自动认定它属于住宅。
项目还会记录地址来源、匹配精度和住宅证据。对于无法确认的字段,会保留空值,而不是通过附近地址、邮编推测或者翻译结果反向补全。
如果开发的是普通地址输入表单,街道级记录可能已经足够;如果测试的是住宅配送、物业管理或收货地址场景,则应该优先筛选具有住宅证据的记录。
多语言地址展示适合国际化项目
国际化网站经常需要面对一个问题:同一个地址在不同语言环境下应该如何展示?
例如,日本地址可能需要以日文原始形式展示,也可能需要提供英文版本;中国地址则可能需要在中文和英文之间切换。
Address支持10种展示语言:
各国家和地区的原生语言。
英语。
简体中文。
繁体中文。
日语。
韩语。
德语。
法语。
西班牙语。
葡萄牙语。
用户可以在Web界面中选择目标展示语言,也可以通过API提交翻译请求。
这里需要注意,地址翻译并不是重新创造一个地址。街道名称、门牌号码、单元号码和邮政编码等信息需要保持原有对应关系,不能因为翻译而改变地址的实际含义。
项目的API文档还说明,如果某个地址没有有效的目标语言翻译结果,接口会返回回退或不可用状态,调用方可以选择展示原始地址。
对于需要支持多语言地址表单的开发团队,这种处理方式比直接使用普通机器翻译更容易控制数据一致性。
网页界面可以按地区筛选地址
Address提供了独立的Web使用界面,不需要编写代码也可以生成地址。
用户进入页面后,可以选择国家、地区以及需要使用的展示语言,再根据具体的行政区域进行筛选。
主要筛选条件包括:
国家:选择需要生成地址的国家或地区。
州省或区域:限定地址所属的上级行政区域。
城市:选择具体城市。
区县:进一步缩小地址范围。
邮政编码:按照邮编条件筛选符合要求的地址。
这种多级筛选方式对于开发测试比较有用。例如,测试人员不需要生成一个完全随机的美国地址,而是可以指定某个城市,只获取该城市范围内符合条件的地址。
项目还有一个值得关注的设计:严格执行地区匹配。
如果指定的城市或区县没有符合条件的数据,系统会返回无匹配结果,而不是自动退回到附近城市、省份或者整个国家寻找其他地址。
这样做虽然可能让部分查询返回空结果,但能够避免测试数据与指定地区不一致。对于地址验证和配送区域测试来说,明确知道某个地区没有数据,比返回一条看似正常但实际不符合条件的地址更可靠。
生成结果还可以复制、导出、保存到收藏夹,并通过Google Maps或高德地图查看对应位置,方便人工检查地址信息。
合成测试资料可以与地址一起生成
除了真实地址,Address还支持生成与地址关联返回的合成测试资料。
这里的合成资料并不是从真实居民数据库中提取的个人身份信息,而是用于开发和测试的虚构资料。
根据API文档,相关测试资料可以涉及:
合成人物资料。
测试银行卡信息。
工作和就业相关测试数据。
网络相关测试信息。
这些资料与真实地址数据是相互独立的。也就是说,地址本身来自可追溯的数据源,而人物、银行卡和就业等资料属于合成测试内容。
这种组合方式适合需要完整测试用户资料表单的项目。例如,一个注册流程可能同时包含姓名、地址、联系方式和职业信息,使用单独的随机字符串逐个填写并不方便。
需要特别注意,中国大陆地区的地址数据还有一项特殊规则:部分建筑名称、楼栋、单元、楼层和房间信息可能属于合成字段,并会明确标记为synthetic。
因此,即使基础住宅小区信息来自真实数据,也不能将这些合成的细分门牌信息当作真实住户的实际居住地址。
这类数据适合用于测试环境、界面演示和自动化测试,不应该被用于真实收货、冒充他人身份或其他需要真实身份验证的业务。
通过API实现单条和批量生成
如果需要在自动化测试、网站后台或者业务系统中持续获取地址,逐条打开网页复制显然不够方便。
Address提供了基于JSON的REST API,支持单条地址生成、批量生成、地区搜索、覆盖率查询和地址翻译等操作。
API采用Bearer Token认证。用户需要先进入管理后台创建API Token,然后在请求Header中携带对应令牌。
例如,下面是通过API生成指定城市地址的基本请求方式:
curl -fsS \
  "https://address.example.com/api/v1/generate?country=US&city=Seattle" \
  -H "Authorization: Bearer YOUR_API_TOKEN"
其中,address.example.com需要替换为实际部署的服务域名,YOUR_API_TOKEN则需要替换成自己创建的API令牌。
除了单条生成,项目还支持批量生成接口POST /api/v1/generate/batch,单次请求最多可以生成50条地址。
批量生成还提供一些实用参数:
count:指定本次需要生成的地址数量,范围为1至50。
unique:控制同一批次是否避免重复地址。
seed:设置固定随机种子,便于重复生成相同的测试记录。
excludeAddressIds:排除已经使用过的地址ID。
filters:指定国家、城市等筛选条件。
其中,seed对于自动化测试尤其有用。普通随机生成每次可能返回不同记录,而固定种子可以让测试过程更容易复现,便于排查问题。
API还支持根据IP所在区域生成地址的模式。对于需要模拟不同地区访问场景的测试系统,可以结合IP区域识别功能选择相应地区的数据。
项目提供OpenAPI 3.1文档,部署完成后可以通过接口文档查看参数、响应结构和错误代码,方便开发人员将其接入现有程序。
后台管理与自动数据同步机制
Address并不是一个只依赖静态数据文件的简单生成器。为了持续维护不同国家和地区的地址数据,项目还提供了独立的后台管理系统和自动同步服务。
管理后台主要包含以下功能:
数据仪表盘:查看整体地址数据和服务运行情况。
国家工作区:按照国家查看数据覆盖和同步状态。
同步历史:检查历史数据导入及处理记录。
快捷位置:管理常用国家和地区筛选条件。
数据源凭据:配置需要认证的第三方数据服务。
翻译路由:管理地址翻译所使用的服务配置。
访问控制:设置公共生成页面的访问权限。
API令牌:为外部程序创建和管理访问凭据。
在数据同步方面,Address采用增量导入机制,并对数据来源进行验证和处理。
其同步流程不仅涉及下载数据,还会检查行政区域、地址字段、坐标、语言和数据来源等信息。通过验证的记录才会进入正式地址池。
同步任务还包含有限重试、指数退避、配额等待和来源耗尽检测等机制,避免某个数据源持续失败后无限重复执行。
项目对国家数据完整度也设置了多个条件,包括有效地址总量、最低层行政区域覆盖情况以及不同层级节点数量。只有相关规则同时达到要求,才会将对应国家标记为完成。
这意味着某个国家即使已经导入了不少地址,也不代表其所有地区都已经覆盖。用户可以通过后台和覆盖率API查看实际情况,而不是只看一个总地址数量。
精彩评论