 poxiaoxi博客
做抖音运营时,很容易接触到各种关于算法的说法:账号需要先“养标签”、点赞和收藏分别有固定权重、视频先进入某个固定大小的流量池,达到某个完播率以后才会进入下一层推荐。
这些说法听起来很容易操作,但如果回到抖音近年公开的推荐算法资料,会发现真实系统并没有这么简单。
2025年,抖音上线安全与信任中心,并公开推荐算法的基本运行逻辑。2026年,官方又增加了“体验算法”板块,通过双塔模型、兴趣时钟和Wide&Deep模型等交互演示,把一条内容从海量候选中被筛选、排序并最终进入推荐流的过程进一步展示出来。
从这些公开资料来看,理解抖音算法更合适的方式,不是寻找一个固定的“爆款公式”,而是把它看成一个持续预测“什么内容更适合什么用户”的推荐系统。
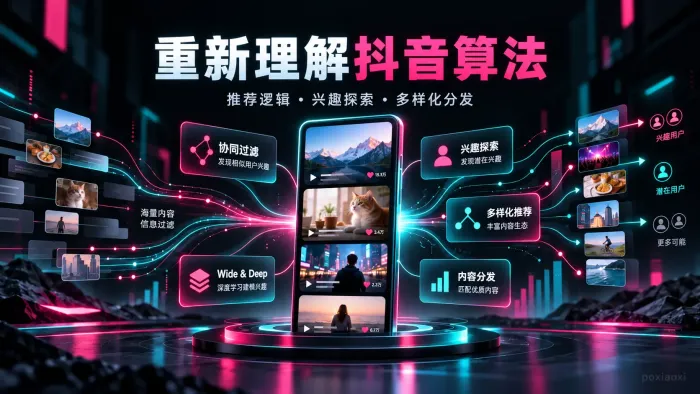
推荐系统本质是内容筛选
抖音每天产生的内容数量很大,而一个用户实际能够看到的内容非常有限。推荐系统需要解决的第一个问题,就是如何从巨量内容中找出一小部分值得继续计算的候选内容。
抖音安全与信任中心把这个过程形容为一个不断筛选的漏斗。
大致来看,推荐过程会经历召回和排序等环节。前面的环节负责从海量内容中快速挑选可能相关的候选内容,后面的模型再进一步计算哪些内容更适合当前用户。
这也意味着,一条视频并不是发布以后简单进入一个统一队列,再按照发布时间依次获得曝光。对于不同用户,同一个内容的匹配程度可能完全不同。
算法并不只是给账号贴标签
“账号标签”是抖音运营讨论中使用频率很高的概念。
例如有人会认为,美食账号必须先让平台识别出“美食标签”,只有标签稳定以后,作品才会被推荐给喜欢美食的人。
这种解释比较直观,但并不能完整描述当前推荐系统。
抖音官方在算法体验页面中特别说明,推荐算法并不依赖语义标签工作,页面中的分类和示例只是为了帮助普通用户理解算法而进行的简化呈现。
推荐系统更重要的依据,是用户、内容和互动之间形成的数据关系。算法可以根据大量历史行为建立数学模型,即使不先把视频准确归类成“摄影”“汽车”或“美食”,也能够判断某类用户与某条内容之间可能存在较高匹配度。
所以“平台到底给我的账号打了什么标签”并不是理解推荐机制的唯一入口。
召回阶段先寻找候选内容
推荐系统面对海量视频,不可能对所有内容同时进行最复杂的计算,因此需要先进行召回。
召回的作用可以理解为粗筛:先从巨大的内容池里找出一批当前用户可能感兴趣的内容,再交给后面的排序系统进一步比较。
抖音目前公开的算法体验中,用双塔模型展示其中一种召回方式。
所谓“双塔”,可以简单理解为分别把用户和内容转化成数学表示,再计算两者之间的匹配关系。匹配程度较高的内容,更容易进入下一阶段的候选列表。
真实推荐系统并不只有一条召回通路。官方也特别说明,实际召回由多个复杂通路和不同模型共同完成,交互页面展示的是便于公众理解的简化过程。
因此,不适合把“双塔模型”理解成抖音推荐系统的全部。
用户兴趣还会随时间变化
抖音2026年的算法体验还展示了一个比较容易被运营人员忽略的因素:时间。
同一个人的兴趣并不是全天固定不变。
例如早上通勤时可能更关注新闻、天气和效率信息,晚上可能更愿意观看娱乐、影视或生活内容。算法可以从长期行为中发现这种时间规律,并把时间因素加入内容选择。
官方将这种演示称为“兴趣时钟”。
它反映出一个重要问题:推荐不是简单的“用户喜欢A,所以永远推荐A”,而是在用户、内容、时间和历史行为等多个条件共同作用下动态计算。
这也解释了为什么同一条视频在不同时间、不同人群中的推荐效果可能存在明显差异。
排序阶段决定推荐优先级
经过召回以后,系统仍然会留下大量候选内容,需要继续进行排序。
官方的算法体验使用Wide&Deep模型帮助用户理解这一过程。
Wide部分可以理解为更擅长利用已经出现过的历史关联。例如某类行为组合过去经常与某种内容产生良好反馈,系统可以继续利用这种关联。
Deep部分则具有更强的泛化能力,可以从复杂数据中发现过去没有直接出现过的新关系。
两部分结合以后,系统能够同时利用已有经验和潜在兴趣,对候选内容进一步打分和排序。
对于创作者而言,真正值得关注的不是模型名称本身,而是排序系统并不会只看一个指标。
哪些用户行为会影响推荐
根据抖音公开的算法及模型备案说明,个性化推荐会参考用户历史的点击、观看时长、点赞、评论、分享、转发、不喜欢等行为,并通过模型预测用户对内容产生互动的概率。
抖音隐私政策中还列出了搜索、关注、收藏、浏览、下载等用户行为信息。
这些信号共同帮助系统学习用户偏好。
因此,不宜把抖音算法简化成下面这样的公式:
点赞 = 1分
评论 = 2分
收藏 = 3分
完播 = 5分
至少在目前公开的官方资料中,并没有这样一套适用于所有内容、所有用户和所有场景的固定公开权重表。
现实中的推荐系统是模型预测问题。同一个行为发生在不同用户、不同内容和不同场景下,产生的信息价值可能并不一样。
完播率不是唯一判断标准
短视频运营中,经常有人特别关注完播率,并把它看作决定作品能不能继续获得推荐的唯一指标。
观看行为当然重要,但官方公开机制描述的是多目标预测,而不是单指标决策。
用户有没有继续观看、是否收藏、分享、评论,是否产生负反馈,以及不同用户群体对内容的整体反应,都可能为模型提供信息。
例如一条几秒钟的视频天然更容易获得较高完播率,而一条几十分钟的知识内容更可能通过收藏、重复观看或后续搜索体现价值。如果所有内容只用同一个完播指标判断,显然难以覆盖不同内容形态。
因此,运营时可以分析完播率,但没有必要把所有优化动作都围绕一个数字展开。
算法为什么会推荐陌生内容
如果推荐系统只根据历史行为不断强化已有兴趣,很容易出现一个问题:用户看的内容越来越相似。
抖音公开资料中明确提到了“兴趣探索”和多样性机制。
平台会通过打散、多样性调节、兴趣探索等方式,让推荐列表中出现一些用户过去不常观看的内容,尝试发现新的潜在兴趣。
在2026年的交互演示中,用户甚至可以调整随机扰动程度,观察推荐列表从相对集中变得更加多元。
这说明推荐系统存在“利用”和“探索”之间的平衡。
利用,是继续推荐系统已经比较确定用户感兴趣的内容。
探索,是尝试新的内容类型,判断用户是否存在还没有被发现的兴趣。
对创作者来说,这一点很重要,因为小众内容并不意味着完全没有获得推荐的机会。只要内容能够找到匹配的用户群体,推荐系统仍然可能逐步发现这种关系。
信息茧房并非只靠精准推荐
推荐算法经常与“信息茧房”一起讨论。
精准推荐确实存在让用户反复接触相似内容的可能,因此抖音公开的算法机制中特别加入了多样性打散、兴趣探索和随机内容等设计。
平台还提供“不感兴趣”、内容偏好管理等用户控制方式,使用户行为可以反过来影响推荐结果。
不过,这并不意味着技术机制可以彻底消除信息单一的问题。实际信息环境还受到用户主动搜索、关注对象、社交关系、内容供给以及个人选择习惯等多种因素影响。
更准确的理解是,平台正在通过推荐系统和产品功能降低内容过度集中带来的问题,而不是证明信息茧房已经不存在。
搜索和推荐正在相互补充
过去很多运营人员只关注推荐流,认为一条视频发布几天以后没有继续获得推荐,生命周期基本就结束了。
但抖音已经不只是一个单纯依靠上下滑动发现内容的平台。
用户会主动搜索教程、产品、攻略、新闻和具体问题,平台的个性化推荐服务也覆盖搜索结果等场景。
这意味着,一部分知识型、教程型和问题解决型内容可能同时面对两种需求:
在推荐流中让潜在用户发现。
在用户主动搜索时提供答案。
因此,标题、字幕、口播表达和内容主题是否清晰,也会影响用户能不能理解内容以及后续能否通过搜索再次发现它。
这和单纯追求视频发布后的第一波流量,是不同的内容运营思路。
平台治理也参与内容分发
算法预测用户可能喜欢什么,并不意味着所有高互动内容都会无限获得推荐。
抖音公开资料同时强调了平台治理体系的作用。
推荐模型负责从用户行为中学习和预测,而内容安全、社区规则以及人工和机器审核则会对整个系统设置边界。违法违规、不良信息以及违反平台规范的内容,不会因为互动数据高就自动获得正常推荐。
因此,算法不能脱离平台规则单独理解。
运营人员研究推荐机制之前,至少应该同时了解社区规范和内容治理要求。否则只研究点击、互动和停留时间,很容易把内容优化带向另一个方向。
常见的算法说法要谨慎看
网上关于抖音算法的教程很多,但其中一些内容把复杂推荐系统包装成了容易传播的固定规则。
比较常见的说法包括:
新视频一定先进入固定人数的流量池。
点赞、评论、收藏分别存在固定权重。
达到某个完播率一定进入下一层流量。
账号必须经过固定天数的养号才能获得推荐。
只要把账号标签做准,内容自然就会获得流量。
这些说法中可能包含运营人员根据自身数据总结出的经验,但不能因此直接当作抖音官方公开规则。
目前官方能够确认的是,推荐系统会通过用户行为数据进行模型学习和概率预测,并经历召回、排序、打散、干预和多样性调节等过程。
至于某个具体指标占多少权重、多少播放进入下一阶段,官方公开资料并没有提供一套所有账号通用的固定公式。
精彩评论