 poxiaoxi博客
中文输入法看起来只是一个将拼音转换成汉字的工具,但在实际使用中,真正影响输入效率的往往不是打字速度,而是选词准确率。尤其是在输入较长的句子时,同音字、词语切分和上下文理解都会影响最终结果。如果经常需要输入技术文档、代码说明或长篇文字,频繁修改候选词可能会打断写作节奏。
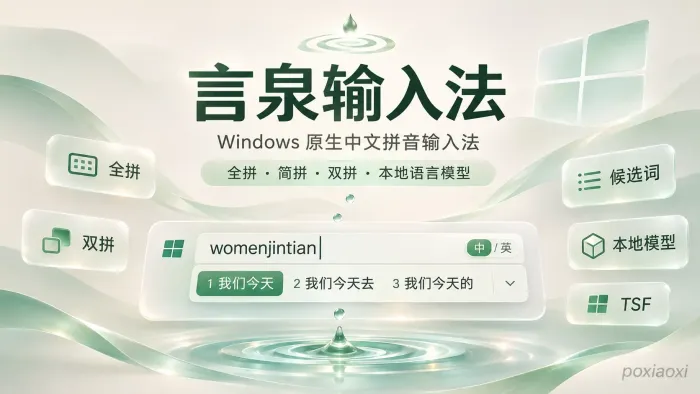
GitHub上的Cassotis IME(中文名称:言泉输入法)就是一个试图改善这些问题的开源输入法项目。它面向Windows 10和Windows 11开发,基于Delphi和Windows TSF(Text Services Framework)实现输入法功能,并使用项目自行训练的本地中文语言模型优化候选词排序。
与依赖云端AI服务的输入工具不同,言泉的智能选词和补全主要在本机CPU上完成,不需要连接网络,也不需要GPU。它支持全拼、七种双拼方案、简繁体词库、英文识别、长句纠错和自定义短语等功能,定位更偏向注重输入准确率和本地运行体验的用户。
言泉输入法采用什么技术架构
Cassotis IME的中文名称是言泉,英文名称Cassotis来源于德尔斐神庙中的圣泉,中文名称则取自言如泉涌的含义,表达了项目希望提供流畅、智能输入体验的设计理念。
从技术实现来看,它并不是简单封装现有输入法引擎,而是基于Windows原生TSF文本服务框架构建的一套输入法系统。
TSF是Windows提供的文本输入服务框架,负责输入法与应用程序之间的交互。通过TSF,输入法可以接收键盘输入、显示候选窗口,并将最终选择的文字提交到当前应用程序。
言泉采用模块化架构,主要包含以下几个部分:
TSF文本服务:负责接入Windows输入系统,处理输入状态和文字组合生命周期。
输入引擎:负责拼音解析、候选词生成、词语排序和用户学习。
Host进程:负责协调输入引擎、界面和本地语言模型推理。
候选窗口:负责显示候选词、翻页、选词和补全提示。
本地词库:保存简体、繁体基础词库以及用户自定义词语。
语言模型:根据拼音、候选词和上下文判断更合适的文字组合。
这种设计将Windows输入法接入层与语言模型运行环境分开,避免直接把较复杂的模型推理工作放在TSF进程内。
即使语言模型尚未加载完成,或者模型文件不可用,输入法仍然可以通过词库提供基础候选,只是候选排序不会经过语言模型优化。
全拼与七种双拼方案都能使用
对于中文输入法来说,拼音方案直接影响用户的学习成本。习惯全拼的用户希望直接输入完整拼音,而熟悉双拼的用户则更关注编码规则和输入效率。
言泉同时支持全拼和七种双拼方案,不需要为不同输入方式使用不同的词库和排序系统。
目前支持的双拼方案包括:
微软双拼
小鹤双拼
自然码双拼
搜狗双拼
紫光双拼
拼音加加双拼
智能ABC双拼
这些方案共用候选排序和用户学习数据,因此用户切换拼音方案时,不需要重新建立一套独立的选词习惯。
除了完整拼音,输入法还支持首字母简拼。例如,输入jt可以匹配“今天”等词语,减少需要输入的字母数量。
另外,软件提供可配置的模糊音规则,可以根据个人发音习惯处理常见声母和韵母的混淆情况。
需要注意的是,智能ABC双拼在部分编码上有自己的规则。例如,“略”和“虐”分别使用lm和nm,“绿”和“女”使用lv和nv。如果从其他输入法切换过来,建议先熟悉对应方案的编码差异。
本地语言模型如何改善智能选词
传统拼音输入法通常会根据词库频率和用户使用习惯排列候选词。但当多个词语具有相同拼音时,仅依赖词频未必能够准确判断用户真正想输入的内容。
例如,输入“zhongduanchuangkouyipiankongbai”,如果只根据局部拼音和词频进行组合,可能出现“中断窗口一片空白”这样的错误结果,而结合实际语境,正确表达应该是“终端窗口一片空白”。
言泉通过本地中文语言模型处理这类问题。它不仅分析当前输入的拼音,还会参考光标之前已经输入的文字,判断整句话是否连贯。
项目在v2.0.0版本中对模型架构进行了较大调整,将此前多个分散的模型和排序器整合为一个主要语言模型。
根据项目技术说明,这个模型具有以下特点:
采用字符级自回归语言模型。
参数规模约为1.5亿。
包含11层网络结构。
使用1024维隐藏表示。
采用8位量化方式减少运行资源占用。
通过ONNX Runtime在本地运行。
这个模型由项目使用独立中文语料训练,并结合拼音条件参与候选排序和文字纠错。
它不仅用于长句选择,也会参与短词排序、词库外短语组合以及一键补全。相比为不同功能分别维护多个模型,这种架构能够让模型改进同时影响多种输入场景。
需要注意,本地语言模型并不意味着输入法能够理解所有语义。它仍然受到训练语料、词库覆盖范围和拼音匹配条件的限制。对于把握不足的输入,系统会尽量保留原有候选,而不是强行修改文字。
长句输入支持同音纠错与上下文判断
长句输入是言泉重点优化的功能之一。
在传统输入方式中,用户输入一整串拼音后,输入法需要将其切分成多个词语,再根据词库组合出候选句子。如果某个词的拼音对应多个同音词,前面的选择错误可能影响整句话的表达。
言泉采用词库约束的路径搜索方式生成完整候选,再通过语言模型评估不同句子的合理性。
例如:
输入:
womenjintian

候选:
我们今天
在生成候选之后,系统还会结合输入的拼音和光标前的文字,检查选中句子中是否存在明显的同音字错误。
v2.6.0进一步改进了长句纠错逻辑。现在由拼音纠错模型和语言模型共同判断是否需要改写,而不是单独依赖某个模型的评分。
另外,纠错范围也不再局限于替换一个汉字。系统可以将句子中的两到四字词语替换成相同拼音下的其他常用词,再比较完整句子的合理程度。
例如,输入拼音可能得到“像是从水面中醒来”,但结合实际表达,系统有机会将其修正为“像是从睡眠中醒来”。
这种处理方式对于技术文档、聊天记录和长篇写作比较有价值,因为用户不需要每次都手动检查所有同音词组合。
一键补全可以减少重复输入
除了常规候选词排序,言泉还有一个比较有特色的功能,就是一键补全。
普通输入法主要根据已经输入的拼音展示候选,而一键补全除了转换当前内容,还可以根据已有词语和上下文预测后续文字。
例如,用户已经输入一个词语或句子的前半部分,输入法可能在专门的补全区域显示一个完整的后续方案。确认后,通过设置的补全按键即可直接上屏。
根据项目说明,一键补全主要有以下特点:
用户词和基础词库中的精确补全可以立即显示。
符合强转移条件的补全可以提前展示。
语言模型在后台对更多候选进行重新排序。
只有当预测结果具有足够优势时才替换当前提示。
如果模型判断把握不足,可以不显示补全内容。
这种设计并不是每输入几个字母就自动猜测整句话,而是优先展示有词库或上下文依据的结果。
对于经常输入固定表达、技术术语和常用句式的用户,一键补全可以减少重复按键,也能让长句输入更加连贯。
自定义短语适合固定内容快速输入
如果经常需要输入固定的签名、地址、工作说明或常用回复,反复输入相同文字会浪费不少时间。
言泉提供自定义短语功能,允许用户为一段文字设置字母快捷码。输入完整快捷码后,短语会出现在一键补全区域,按补全键即可将整段内容原样上屏。
例如,可以将常用内容设置成这样的对应关系:
快捷码:mydz
内容:北京市某某区某某街道……

快捷码:myqm
内容:祝工作顺利,生活愉快!

快捷码:myinfo
内容:姓名:
联系方式:
联系地址:
这里的快捷码和内容只是使用示例,用户可以根据自己的实际需求进行设置。
这项功能还有几个值得关注的细节:
支持多行文本,换行内容也可以原样输出。
支持调整短语列表的顺序。
可以通过JSON文件导入和导出配置。
自定义短语单独保存,不参与普通用户词学习。
不会改变原有数字候选和空格选词逻辑。
对于经常处理客服回复、办公文档和代码注释的用户,这项功能比单纯增加候选词更直接,可以将固定文字变成可重复调用的快捷内容。
英文识别与Markdown标点更方便
中文输入时,有时输入的一串字母并不是拼音,而是一个英文单词、软件名称或者技术术语。
例如,输入markdown时,用户通常希望直接输出英文,而不是让输入法将字母拆解成拼音候选。
言泉提供英文识别功能,在中文全拼和半角输入模式下,可以将英文单词、名称、带大写字母的输入,以及之前曾经按字母上屏的内容放在编号候选之前。
如果输入内容没有完整的中文读音,系统可以直接选中英文候选;如果同时存在中文和英文解释,例如bug或mac,则会结合前文判断应该优先显示哪一种结果。
对于程序员和经常编写技术文档的用户,中文标点处理也比较重要。
言泉支持自定义半角符号保留规则,并提供Markdown预设。默认预设会让以下符号保持ASCII形式:
- # * + _ = ` ~ [ ] < > | @
逗号、句号、问号、感叹号、括号和引号仍然按照中文标点习惯输出,反斜杠则可以输入顿号。
这样在编写Markdown标题、列表、代码片段和链接时,就不必频繁切换中英文输入模式来处理特殊符号。
快捷输入与候选窗口有哪些细节
除了常规文字输入,言泉还提供了一些辅助输入功能,可以通过特定编码快速输入符号、日期和数字金额。
项目提供的快捷输入包括:
ufh:快速输入符号。uxh:输入数字序号标记。usx:输入数学符号。urq:输入当前日期。i123.45或v123.45:转换中文数字和金额大写。
其中,数字和金额转换功能适合处理文档、财务说明和日常办公内容。输入对应编码后,可以根据候选窗口显示的选项完成转换。
双拼用户需要注意,部分快捷输入模式需要通过Shift+U、Shift+I或Shift+V进入。
在候选窗口方面,软件支持翻页和最多三行的展开显示。开启多行模式后,可以通过翻页或上下方向键浏览候选,并通过数字键选择当前行的内容。
另外,言泉会在光标附近短暂显示当前中英文输入状态。切换输入模式或从其他输入法切换到言泉时,光标上方会出现对应的标识,帮助用户确认当前处于中文还是英文状态。
这项设计尤其适合经常在中文和英文之间切换的用户,可以减少忘记输入状态而产生的错误内容。
本地运行不需要联网和GPU
对于输入法来说,用户隐私和运行效率同样重要。尤其是在输入邮件、工作文档、代码和个人信息时,很多用户会关注输入内容是否需要上传到远程服务器。
言泉的一个重要设计原则就是本地运行。
根据项目说明,候选生成、语言模型推理和智能排序都在本机CPU上完成,不需要将输入内容发送到云端,也不需要使用GPU。
项目使用ONNX Runtime运行语言模型,并将模型加载工作放在独立的Host进程中。模型尚未加载完成时,输入法仍然可以通过基础词库正常提供候选。
这种设计有几个实际价值:
减少网络依赖:安装完成后,输入法的核心智能选词不依赖在线API。
不需要GPU:普通CPU电脑也可以运行语言模型。
降低云端传输需求:输入内容不需要为了候选排序而发送给远程模型服务。
离线可用:网络不可用时,基础输入和本地模型功能仍然可以使用。
需要区分的是,本地运行并不意味着安装过程不需要下载文件。Windows安装包约290MB,其中已经包含简体、繁体基础词库和语言模型。下载和升级仍然需要获取对应安装文件。
另外,本地运行也不等于绝对没有隐私风险。用户仍然需要妥善管理本机配置、用户词库和日志文件,并从项目官方渠道获取安装包。
精彩评论